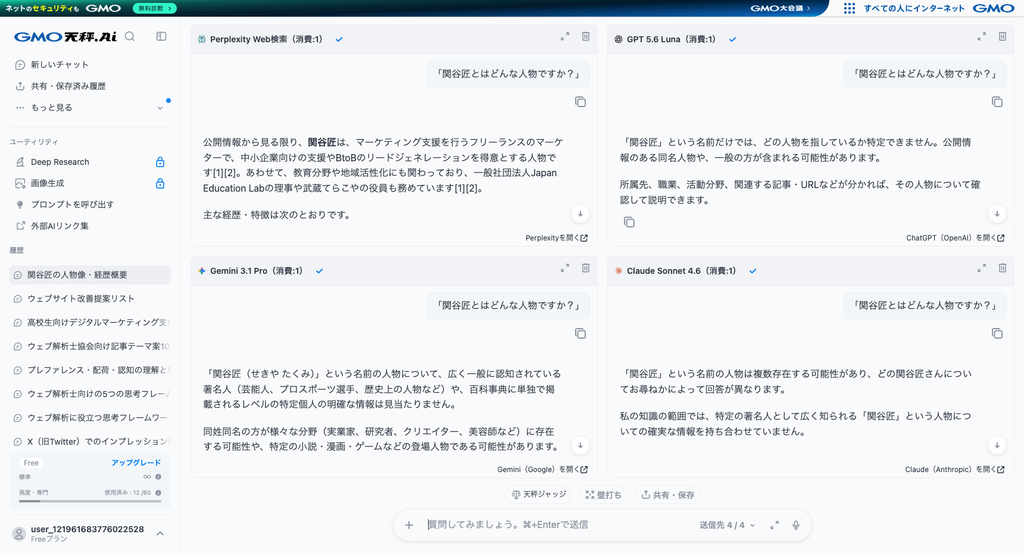
最初に使ったのは、複数の生成AIへ同じ質問を同時に投げられる「天秤AI」です。
「関谷匠とはどんな人物ですか?」
Perplexity、ChatGPT、Gemini、Claudeに同じ質問を投げてみました。
結果はかなりはっきり分かれました。
Perplexityは私をマーケターとして認識し、経歴や活動まで説明しました。
一方で、ChatGPT、Gemini、Claudeは、名前だけでは人物を特定できませんでした。
同じ質問でも、AIによって人物認識にかなり差がある。
ここが今回の調査のスタート地点です。
天秤AIで4つの生成AIに同じ質問をしたところ、Perplexityは人物として認識した一方、ChatGPT・Gemini・Claudeは名前だけでは特定できませんでした。そこで「関谷匠 マーケター」と条件を加えてみます。
すると、Perplexityに加えてGeminiも人物として認識するようになりました。
PerplexityやGeminiが参照していたのは、ウェブ解析士協会、LinkedIn、Wantedlyなどの外部サイトです。
それでもChatGPTとClaudeは、私について確定的な情報を返せませんでした。
さらに「markeTransとは」と聞いてみると、差はもっと分かりやすく出ました。
PerplexityはmarkeTransの公式サイトを参照し、伴走型のマーケティング支援事業として説明しました。
一方、Geminiは名称から海外向けの翻訳・マーケティング事業のように推測。ChatGPTとClaudeからは、markeTransについて確定的な情報は得られませんでした。
ここで気になったのが、
同じWeb上の情報を見ているはずなのに、AIによって公式サイトの認識にかなり差がある
ということです。
「では、markeTransのサイト側はどう見えているんだろう?」
ここから調査を始めました。
最初はAIからの見え方を調べていただけなのですが、原因を追っていくうちに、構造化データ、クロール、サイトマップ、robots.txtまで確認することになります。
結果的には、いわゆるLLMOだけではなく、SEOの技術的な土台を見直すことになりました。
まず確認したのは構造化データ
最初に確認したのが構造化データです。
構造化データというと少し難しそうですが、考え方はそれほど複雑ではありません。
人がページを読めば、
「これは人物紹介だな」
「これは会社情報だな」
「これは記事だな」
と自然に判断できます。
検索エンジンに対しても、
- Person=人物
- Organization=組織
- Article=記事
- Service=サービス
といった形で、情報の意味や関係を機械的に伝えることができます。
markeTransのサイトも確認してみました。
Aboutページには、関谷匠という人物について、
- 名前
- 英語表記
- markeTrans代表
- マーケター
- Webプロデューサー
- 専門領域
- 資格
- 外部プロフィール
など、かなりの情報があります。
ただ、ページに文章として書いてあることと、検索エンジンが構造として理解できることは別です。
そこで、人物情報とmarkeTransという事業の関係まで含めて、構造化データを整理していきました。
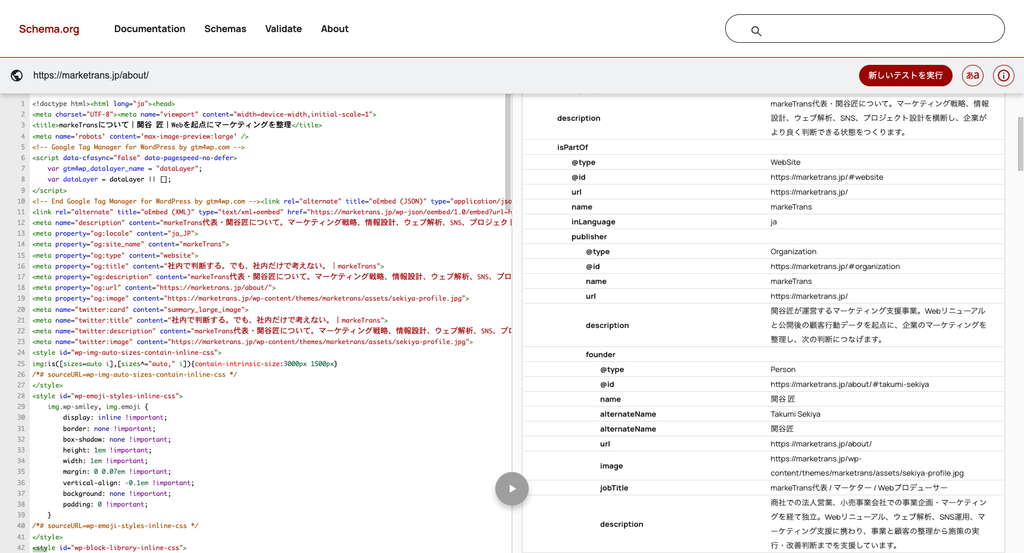
Aboutページの構造化データを確認。PersonとOrganizationを中心に、人物と事業の関係を機械的にも伝えられる形に整理しました。「人」「事業」「記事」をバラバラにしない
今回意識したのは、構造化データの種類をただ増やすことではありません。
それぞれの情報の関係をつなぐことです。
markeTransで考えると、
markeTrans
↓
代表:関谷匠
↓
関谷匠が記事を書く
↓
markeTransがサービスを提供する
↓
事例や知見記事がある
という関係です。
サイトを見る人にとっては当たり前の関係ですが、機械にとっても同じように分かりやすいとは限りません。
そこでPersonやOrganizationを中心に、サイト内の情報が一つのまとまりとして認識されやすい形へ整理しました。
こうした「固有の存在」を表す考え方として、SEOではEntity(エンティティ)という言葉も使われます。
難しく考えず、
「これは関谷匠という人物」「これはmarkeTransという事業」と識別し、その関係も分かるようにする
くらいに捉えると分かりやすいと思います。
構造化データを直して、次に気になったこと
構造化データを整えている途中で、次の疑問が出てきました。
そもそもGoogleは、変更後のサイトを読みに来ているのか?
サイト側をいくら直しても、検索エンジンがページを再取得しなければ変更は認識されません。
そこでSearch Consoleを確認しました。
主要なページはGoogleに認識されていました。
ただ、ここで別の改善点が見つかります。
Search Consoleにサイトマップが送信されていなかった
Search Consoleの「サイトマップ」を確認したところ、markeTransのサイトマップが送信されていませんでした。
サイトマップは、簡単に言えば、
「このサイトには、こういうページがあります」と検索エンジンへ伝える一覧表
です。
サイトマップが登録されていなければGoogleに載らない、という意味ではありません。
Googleはリンクをたどってページを発見することもできますし、実際にmarkeTransのページもすでにインデックスされていました。
ただ、markeTransはサイトをリニューアルしたばかりです。
ページ構成が変わったタイミングでもあるので、現在のサイト構成を伝える意味でもサイトマップを送信しておくことにしました。
WordPress標準の、
/wp-sitemap.xml
をSearch Consoleへ登録します。
これで終わり。
……とはいきませんでした。
サイトマップを登録したら「取得できませんでした」
サイトマップを送信したあと、一部で「取得できませんでした」という表示が出ました。
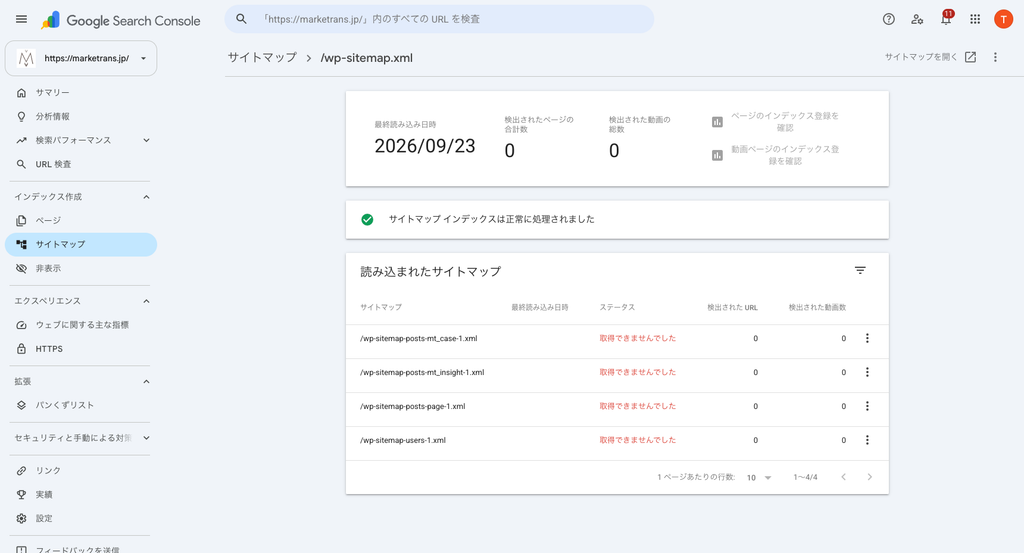
サイトマップ送信直後は、4つの子サイトマップすべてが「取得できませんでした」と表示されていました。こういうときは、原因を一つずつ切り分けます。
まず、サイトマップそのものをブラウザから開いてみます。
これは普通に表示されました。
次に確認したのがrobots.txtです。
robots.txtは、検索エンジンのクローラーに対して、サイト内のどこをクロールしてよいかなどを伝えるためのファイルです。
markeTransでは、次のようになっていました。
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://marketrans.jp/wp-sitemap.xml
WordPressとして特に不自然な内容ではありません。
少なくとも、サイトマップへのアクセスをrobots.txtで拒否している状態ではありませんでした。
整理すると、
- ブラウザからサイトマップは開ける
- robots.txtでもサイトマップをブロックしていない
- 親となるサイトマップも存在している
という状態です。
その後、Search Consoleを再確認すると、全てのサイトマップが「成功しました」に変わりました。
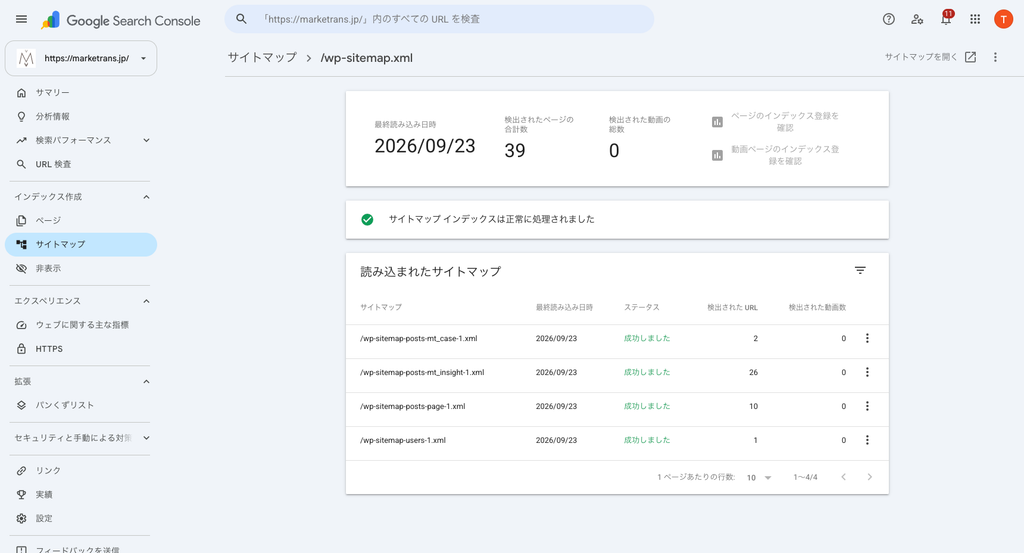
この経過だけで原因を断定することはできませんが、少なくともサイトマップ自体が恒常的にアクセス不能だったわけではなさそうです。
こういうところも、エラー表示だけを見てすぐに何かを直すのではなく、まず何が起きているのかを切り分けることが大切だと思います。
「AIに認識されない」から始めたのに、SEOの基礎まで来ていた
ここまでやってみて面白かったのは、最初の疑問と最終的に確認した場所がかなり離れていたことです。
最初は、
「なぜAIによって、関谷匠やmarkeTransの認識に差があるんだろう?」
という疑問でした。
そこから調べていくと、
- AI上での人物・事業の認識
- 公式サイトが参照されているか
- 構造化データ
- Entity
- クロール
- Search Console
- サイトマップ
- robots.txt
まで確認することになりました。
最初から「LLMO対策をしよう」と思っていたわけではありません。
むしろ、
AIからどう見えているのかを調べていたら、SEOの基礎まで見直すことになった
というのが今回の実態です。
構造化データを入れれば順位が上がる、という話ではない
ここは誤解のないようにしておきたいところです。
構造化データを整えたからといって、それだけで検索順位が上がるわけではありません。
サイトマップをSearch Consoleへ送信したからといって、すべてのページが必ずインデックスされるわけでもありません。
同じように、
「構造化データを入れればChatGPTやGeminiが公式サイトを引用してくれる」
とも言えません。
今回行ったのは、
検索エンジンや生成AIが、サイト内の情報を理解するための土台を整理すること
です。
これによってAIからの見え方がどこまで変わるのかは、これから確認していく必要があります。
ここを混同しないことは重要だと思います。
LLMOは「AI専用のSEO」ではないのかもしれない
LLMOという言葉だけを見ると、
「生成AI向けに何か特別な施策をするもの」
という印象を持つかもしれません。
今回、自分のサイトで調べてみて感じたのは、少し違いました。
結局確認したのは、
- 誰が運営しているサイトなのか
- 何を提供しているのか
- 誰が記事を書いているのか
- どれが公式情報なのか
- 人・事業・記事がどうつながっているのか
- 検索エンジンがページを発見できているか
ということです。
どれも、AIが登場する前からSEOやWebサイト運用で考えてきたことです。
そのため現時点では、
LLMOとSEOを完全に別物として考えるより、かなり地続きのものとして見た方が自然なのではないか
と考えています。
少なくとも今回のmarkeTransでは、AI向けの特別な裏技を入れたというより、サイトの情報構造と検索エンジン向けの基本設定を整理することになりました。
検索エンジン向けの基本設定に加えて、サイト全体の構成や情報の伝え方を見直す際には、Webリニューアルで考えたい9つのことも参考になります。
「AIに出た」だけではなく、なぜそうなったのかを見る
今回のような検証で避けたいのは、
「AIに出た」
「AIに出なかった」
「インデックスされた」
「順位が上がった」
という結果だけを見て終わることです。
重要なのは、
なぜそうなったのかを考えること。
今回も、
「AIによって人物認識に差がある」
という現象から、
- 人物として認識されているか
- どの情報源を参照しているか
- 公式サイトに必要な情報があるか
- その情報が構造化されているか
- Googleはサイトを認識しているか
- サイトマップは送られているか
- robots.txtで妨げていないか
と、一つずつ確認していきました。
これはSEOに限った話ではありません。
Webサイトを改善するときは、結果を見て「良かった」「悪かった」で終わるのではなく、
どこで問題が起きているのかを分解して、次に確認する場所を決める。
結局、普段Web解析でやっていることと同じでした。
本当にAIからの見え方は変わるのか
ここからは経過観察です。
今回の調査をきっかけに、
- 人物・事業情報の構造化を見直す
- PersonとOrganizationの関係を整理する
- 記事と著者の関係を整理する
- サイトマップをSearch Consoleへ送信する
- robots.txtを確認する
といった対応を進めました。
次に確認したいのは、これらの変更が各AIの認識にどう影響するかです。
変更前には、
「関谷匠」だけで人物を認識できたのはPerplexityだけ。
「関谷匠 マーケター」とした場合はPerplexityとGeminiが認識し、ChatGPTとClaudeでは特定できませんでした。
また「markeTransとは」と聞いた場合も、Perplexityは公式サイトを参照できた一方、ほかのAIでは認識が曖昧でした。
この状態が今後どう変わるのか。
同じ質問を繰り返して、Before / Afterで確認してみる予定です。
公式サイトが参照されるようになるのか。
人物と事業の関係がより正確に説明されるのか。
それとも、ほとんど変わらないのか。
変わらなかったとしても、それも一つの検証結果です。
Web改善は、一度の修正で正解を当てるものではありません。
仮説を立てる。
直す。
確認する。
また考える。
今回も、その一つです。
まとめ:AI対策をしていたら、Webサイトの基礎体力を見直すことになった
今回のスタート地点は、
AIによって、自分やmarkeTransの認識にかなり差がある
という小さな違和感でした。
そこから調べていくと、
- AI上の人物認識
- 公式サイトの参照状況
- 構造化データ
- Entity
- クロール
- サイトマップ
- robots.txt
までつながりました。
結果として行ったのは、
AI専用の対策というより、Webサイトの基礎体力を整える作業
だったと思います。
AI検索が広がったとしても、
「自分たちは誰なのか」
「何を提供しているのか」
「どの情報が公式なのか」
をWeb上で明確に伝えることの重要性は変わりません。
LLMOという言葉だけを追いかける前に、
まず、自分たちのサイトが検索エンジンや生成AIからどう見えているのか。
実際に確認し、違和感があれば原因を一つずつ追ってみる。
そうすると、AI対策とは少し違うところに、本当に直すべき場所が見つかるかもしれません。